面向 AI Fabric 的 InfiniBand 与 Ethernet 对比
对多数 AI fabric 而言,选以太网;对延迟敏感的 HPC,则选 InfiniBand。 如今,采用 RoCEv2 的现代以太网已能在开放的多厂商硬件上以 400G 和 800G 运行生产级 fabric,OcNOS-DC 现已交付这一能力。本指南阐述两者各自仍然适用的场景。
同样的 GPU,两张截然不同的网络
左侧是单一厂商的 InfiniBand fabric:一家芯片厂商、一条交换机产品线、一套 NIC 生态,以及一个独立于数据中心其余部分的子网管理器。右侧是多厂商的开放以太网 fabric:来自任意厂商的 RoCEv2 NIC、Broadcom 交换芯片、作为 NOS 的 OcNOS-DC,以及您已在运行的同一套协议。
InfiniBand 与以太网,逐项对比
InfiniBand 专为低延迟、无损 RDMA 而生,二十年来在紧耦合 HPC 上确有真正的优势。而基于 DCB 协议栈、RoCEv2,以及日益成熟的 DLB 和 UEC 构建的现代以太网,近几年一直在缩小这一差距。哪些差距仍然重要,取决于具体工作负载。
| 维度 | InfiniBand单一厂商 | EthernetRoCEv2 / UEC,开放 |
|---|---|---|
| 时延下限 | 端到端 NIC 到 NIC 时延极低;交换机单跳通常为数百纳秒。 | 时延下限比 IB 高出数百纳秒,但仍远低于会影响大规模分布式训练集合通信的阈值。 |
| 丢包容忍度 | 架构层面无损(基于信用的流量控制)。 | 通过 PFC + ECN + DCQCN 实现无损。如今已达生产级;UEC 进一步降低对 PFC 暂停的依赖。 |
| 多路径 / 负载均衡 | 自适应路由已内置于规范中。 | 静态 ECMP,外加用于拥塞感知单跳均衡的 DLB、用于端到端的 GLB(OcNOS 7.1),以及面向下一代的 UEC 报文喷洒。 |
| 厂商生态系统 | 在 NIC 和交换机芯片方面实际上均为单一供应商。 | 每一层均支持多厂商:ASIC、交换机、NIC、NOS、光模块。UEC 明确为厂商中立的互操作而设计。 |
| 运营模式 | 子网管理器。与 DC 其他部分不同。需要单独的技能和单独的工具。 | 沿用您已在运行的 BGP、EVPN、gNMI。与数据中心其余部分采用相同的自动化工具(Ansible、NETCONF、OpenConfig)。 |
| 多租户 | 有限;存在分区机制,但并非一流概念。 | 通过 EVPN-VXLAN 原生支持。GPU-as-a-Service、多团队集群、共享基础设施皆水到渠成。 |
| 长距离 DCI | 并非为此设计;需要 IB-over-WAN 网关。 | 通过 400G ZR/ZR+ 相干可插拔模块和 EVPN 跨数据中心原生实现。 |
| 存储融合 | 存储与计算并行运行;需要 IB 连接的存储。 | NVMe-oF、NFS、S3 全部运行在同一套以太网网络上。 |
| 路线图推进速度 | 受制于单一厂商的版本发布节奏。 | 成员涵盖芯片、NIC、交换机和云计算企业的 UEC 联盟推动着公开发布的规范演进。 |
各自的制胜场景
正确答案因工作负载而异。当绝对延迟下限是硬性要求时,选 InfiniBand;当运营模式、成本或跨站点覆盖决定成败时,选以太网。
延迟下限写进了合同
在绝对延迟下限比总拥有成本更重要的 HPC 仿真场景,以及可以接受锁定的紧凑、封闭式单租户集群中。
运营模式才是关键
多租户 GPU 即服务,以及与数据中心其余部分共享基础设施的集群,在这些场景中,统一的运营模式、统一的工具链和多厂商供应链会胜出。
每 GPU-flop 成本是决定门槛
OcNOS-DC 运行在多家厂商的开放硬件上,因此交换硬件可以通过竞争方式采购。
fabric 需要跨越多个数据中心
如果训练任务将来需要跨越两个机房或两个区域,相干 DCI、EVPN 跨 DC 互联与标准多厂商光模块可将同一以太网 fabric 延伸到多个站点。
现代以太网新增了什么
三项进展把生产级 AI fabric 推向了以太网:真正的无损行为、让流量避开拥塞上行链路的负载均衡,以及适合喷洒的下一代传输。
动态负载均衡
AI 工作负载上的静态 ECMP 冲突确实存在,但 DLB 会在本地拥塞时重新分配 flowlet,而 OcNOS 7.1 中的 GLB 会将其扩展为端到端路径评分。
适合喷洒的传输
Ultra Ethernet(UEC 1.0,2025 年 6 月)为标准以太网带来 数据包喷洒、多路径 RDMA 和乱序交付 。现在即可基于 RoCEv2 构建,并随着支持 UEC 的 NIC 上市规划 UEC。
网络只是一小笔开支,因此对比的重点应放在它所释放的价值上
- OcNOS-DC 运行在多家厂商的开放硬件上,因此交换硬件可以通过竞争方式采购。
- 省下的资本可用于购置更多 GPU、更大的存储层,或建设用于冗余的第二站点。
- 当 fabric 属于多租户或与数据中心其余部分共享时,统一的网络模型所带来的价值超过那点开支差异。
两者各有其位,而多数 AI fabric 归属以太网
以太网并非在每种工作负载上都胜出,但对多数场景而言,其运营与经济上的理由具有决定性,且随着技术差距缩小而愈发有力。
两者各有其位
以太网并非在每种工作负载上都胜出。对绝对延迟下限有要求的紧耦合 HPC 集群,仍然更青睐 InfiniBand。
多数 AI fabric 归属以太网
随着运营与经济理由日益充分、技术差距持续缩小,超大规模的生产级 AI 训练与推理正在转向以太网。
OcNOS-DC 是通往开放的路径
当前提供 RoCEv2 与 DLB,GLB 将在 OcNOS 7.1 中推出。同一个 NOS 运行在 Edgecore、UfiSpace 等厂商经过认证的开放硬件上。
InfiniBand 与以太网,答案在此
与 InfiniBand 相比,Ethernet 对于 AI 训练是否足够快?
在哪些情况下仍应选择 InfiniBand?
在 AI fabric 中,Ethernet 何时更具优势?
OcNOS 如何缩小与 InfiniBand 的差距?
超大规模厂商是否正在用以太网取代 InfiniBand 来做 AI?
AI 集群组网中,InfiniBand 的最佳替代方案是什么?
Ultra Ethernet 与 InfiniBand 有何区别?
以太网 AI fabric 相比 InfiniBand 成本如何?
深入了解,随身带走。
产品数据手册,以及内容比本页更为深入的简明技术下载资料。
OcNOS-DC 数据手册
完整的 OcNOS-DC 规格:EVPN-VXLAN 与 Ethernet for AI 功能集、软件 SKU、支持的硬件平台,以及解决方案订购指南。
获取数据手册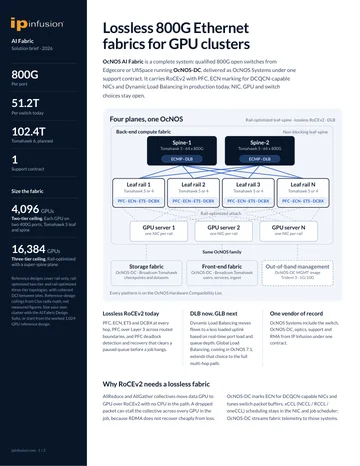
OcNOS 800G 无损 AI Fabric
基于 Tomahawk 5 spine 的无损 RoCEv2 fabric:SKU 等级、经过认证的平台和部署架构。
获取简报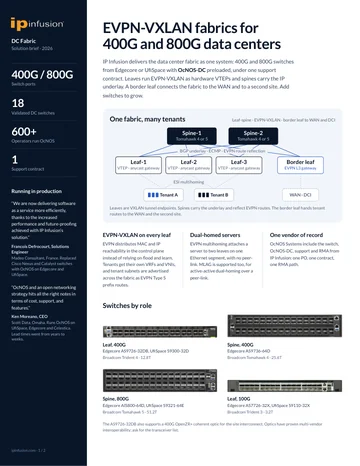
EVPN-VXLAN 数据中心网络
基于 EVPN-VXLAN 的 leaf-spine 数据中心 fabric:每租户一个 VRF 和多个 VNI、EVPN 多归属、BGP unnumbered 和 route-target 过滤。
获取简报OcNOS-DC 数据手册
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
OcNOS 800G 无损 AI Fabric
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
EVPN-VXLAN 数据中心网络
表单简短。提交后您的 PDF 将立即在新标签页中打开。
✓ 正在新标签页中打开您的 PDF……
如果未能自动打开,请使用下方链接。
用 OcNOS 设计整张 AI fabric
从商业论证到端口数量测算,无论您进行到哪一步,都可从此接续。
在规划下一个集群?获取针对具体工作负载的评审
告诉我们工作负载和 GPU 规模,IP Infusion 的工程师将与您一起测算,或先在 AI Fabric Design Suite 中生成一版初步的 leaf-spine 布局。