ダイナミックロードバランシング:AI Fabric向けの輻輳認識型の経路選択
AI ファブリックでは、静的ハッシュのECMPではなくDynamic Load Balancingを使用します。 DLBは、ライブなASIC出力キュー深度およびポート利用率のテレメトリを用いて、パケット間ギャップで区切られたサブフローのまとまりであるフローレットごとに経路を再評価するため、GPUのコレクティブが単一のアップリンク上で衝突しなくなります。Broadcom Tomahawk 4および5のスイッチASIC内で動作し、NICやコレクティブライブラリの変更は不要です。
leaf-spine ファブリック上の動的ロードバランシング
GPUのAllReduceトラフィックを運ぶ、4 spine・2 leafのスライス。DLBはローカルな出力キュー深度をリアルタイムで測定します。Spine-3が飽和すると、leafは次のフローレットをより負荷の低いspineへ再割り当てし、4本すべてのアップリンクのバランスを保ちます。
静的ECMPとDLBを、軸ごとに比較
標準的なECMPはフロー開始時に5タプルをハッシュし、そのフローを寿命の間ピン留めします。north-southのWebトラフィックでは、数百万の短命なフローが経路間の利用率を平準化します。AI ファブリックでは、それぞれが400Gまたは800Gのアップリンク全体を数秒間占有する少数のGPUエレファントフローがハッシュ衝突を引き起こします。一部のアップリンクが飽和する一方で、並列経路が遊休状態になるのです。DLBはライブなASICテレメトリを用いてフローレットごとに経路を再評価します。
| 観点 | 静的 ECMPハッシュしてピン留め | DLB輻輳認識型、フローレット単位 |
|---|---|---|
| 経路の決定 | フロー開始時に5タプルを一度だけハッシュし、そのフローを寿命全体にわたってピン留めします。 | フローレットの境界ごとに経路を再評価し、トラフィックをより輻輳の少ないアップリンクへ移動します。 |
| 粒度 | フロー全体。単一のハッシュ選択が数秒間のエレファントフロートラフィックを支配します。 | フローレット。小さなパケット間ギャップで区切られたサブフローのまとまりで、並べ替えなしに再割り当てしても安全です。 |
| 輻輳シグナル | なし。ハッシュはリアルタイムのリンク状態を認識しません。 | ライブな ASIC 出力キュー深度およびポート利用率のテレメトリ。 |
| GPUエレファントフロー下では | ハッシュ衝突。2つのエレファントが1本のアップリンクに集中し、別のアップリンクが遊休状態になり得ます。 | 飽和したメンバーは候補セットから外れるため、アップリンクはバランスを保ちます。 |
| 並べ替えのリスク | なし。フローはピン留めされますが、ホットスポットとテールレイテンシの外れ値という代償を伴います。 | 実際上なし。パケット間ギャップにより、RoCEv2とTCPは正しい順序どおりの配送を受け取ります。 |
| NIC/コレクティブライブラリ | 変更なし。標準的な動作。 | 変更なし。スイッチASIC内で動作するため、RoCEv2 NICとxCCLスタックはそのまま。 |
| ハードウェア | ECMP対応の任意のスイッチ。 | 64x400Gおよび64x800G構成のBroadcom Tomahawk 4(25.6T)およびTomahawk 5(51.2T)。 |
OcNOS の DLB 実装
DLB はコントロールプレーンへの後付けではありません。Broadcom のフォワーディングパイプライン内で動作し、ライブな輻輳シグナルからすべての ECMP ネクストホップをスコアリングし、ハードウェアでフローレットを再割り当てします。
フローレットギャップタイマー
ASIC ネイティブのフローレット無活動タイマーが、長いエレファントフローを、TCP や RoCEv2 の並べ替えなしに経路間へスプレーしても安全なまとまりに分割します。
キュー深度のリアルタイムフィードバック
DLBはTomahawkパイプラインから出力ポート単位のキュー占有率とリンク使用率のシグナルを取得し、すべてのECMPネクストホップをリアルタイムでスコアリング。
輻輳認識型ネクストホップ選択
各フローレットの境界で最も品質の高いメンバーが選択されるため、飽和したスパインは候補セットから外れます。
TH4 / TH5 ネイティブ
Broadcom Tomahawk 4(25.6T)および Tomahawk 5(51.2T)の spine プラットフォーム上、64x400G および 64x800G のポート構成で認定済み。
DLBがファブリック内で位置する場所
DLB は、より大きなオープン Ethernet トランスポートにおける、シングルホップかつ輻輳を認識するレイヤーです。ロスレス RoCEv2 の上で動作し、OcNOS 7.1 で提供予定のファブリック全体の GLB がこれをエンドツーエンドのスコアリングへと拡張します。
次はファブリック全体のスコアリング
DLBがローカルなネクストホップをスコアリングするのに対し、 GLB(OcNOS 7.1) は、その決定をleaf-spine ファブリック全体にわたるエンドツーエンドの経路品質へと拡張します。
NIC における同じ発想
Ultra Ethernet は、パスの分散を NIC に持ち込みます。パケットスプレーとマルチパス RDMA により、UEC 対応 NIC から 1 つのフローを多数のパスに分散します。
本番 AI ファブリックにおける DLB の提供価値
静的 ECMP が過負荷にする輻輳したアップリンクからフローレットを引き離すことで、DLB は対称型 leaf-spine ファブリックを、GPU コレクティブトラフィック下でも均衡を保つファブリックへと変えます。
- より高い使用率。 フローレットの再バランスにより、静的 ECMP が過負荷にする輻輳したアップリンクからトラフィックを引き離すため、適切に運用されたファブリックは同じハードウェア上で、追加のアップリンクを購入することなく 90 percent を超える利用率を目標にできます。
- より低いテール遅延。 他のリンクがアイドル状態のまま単一リンクが飽和することがないため、コレクティブ完了時間が短縮されます。
- NICの変更不要。 DLB はスイッチ ASIC 内で動作します。既存の RoCEv2 NIC と xCCL(NCCL、RCCL、oneCCL)コレクティブスタックは、コード変更なしに正しい順序どおりの配送を受け取ります。
- PLUSティア。 DLBはOcNOS-DC PLUSのSKUに含まれ、OcNOS-DCのほかの機能と同じサポート契約で提供されます。
動的ロードバランシングは Ethernet AI ファブリックの必須要件
静的 ECMP は南北方向の Web トラフィック向けに作られました。ファブリックが GPU コレクティブを運ぶようになると、動的ロードバランシングは均衡したアップリンクと停止したトレーニングジョブとを分ける決め手となり、OcNOS は本日オープンハードウェア上でそれを提供します。
ECMP だけでは不十分
ごく少数のエレファントフローが静的ハッシングを破綻させます。ハッシュ衝突により、一部のアップリンクが飽和する一方で並行するパスは遊休状態のままとなります。
DLB がルーティングのギャップを埋める
フローレット単位で輻輳を認識したパス選択により、Ethernet ファブリックはコレクティブトラフィック下でも均衡を保ちます。これは InfiniBand が優位性を持っていた軸のひとつです。
OcNOS がイネーブラー
現在は DLB、OcNOS 7.1 では GLB。Edgecore や UfiSpace といったベンダーの認定済みオープンハードウェア上のひとつの NOS で、NIC や集合通信ライブラリの変更は不要です。
ダイナミックロードバランシングにお答えします
flowlet とは何であり、DLB はなぜそれを使用するのですか。
DLB は静的な ECMP とどのように異なりますか。
DLBには、新しいNICや集合演算ライブラリの変更が必要ですか。
どのハードウェアが OcNOS DLB をサポートしていますか。
さらに詳しく。資料をお持ち帰りください。
製品データシートと、このページよりもさらに踏み込んだ簡潔で技術的なダウンロード資料です。
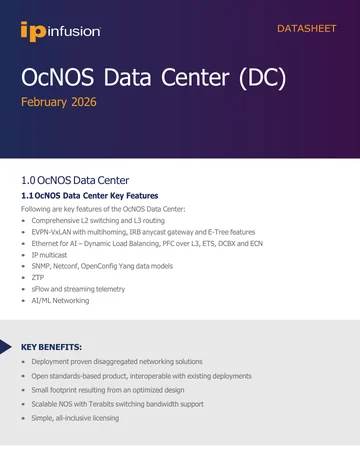
OcNOS-DC データシート
OcNOS-DC の完全な仕様。EVPN-VXLAN と Ethernet for AI の機能セット、ソフトウェア SKU、サポート対象ハードウェアプラットフォーム、ソリューション発注ガイドを収録しています。
データシートを入手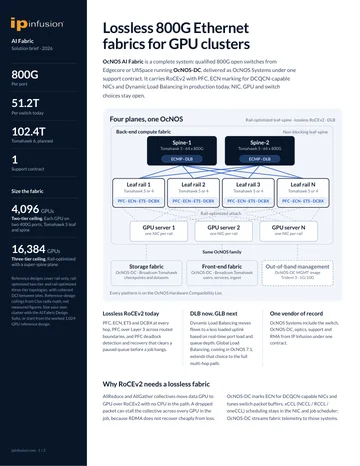
OcNOS 800G ロスレス AI Fabric
Tomahawk 5 スパイン上のロスレス RoCEv2 ファブリック:SKU 階層、認定済みプラットフォーム、導入アーキテクチャ。
概要資料を入手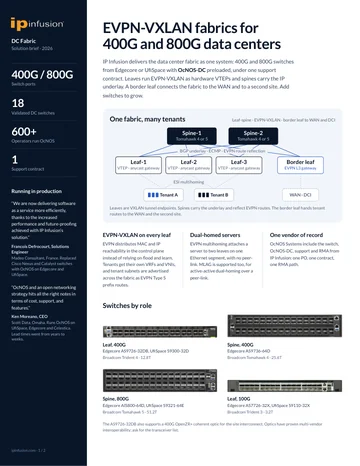
EVPN-VXLAN データセンターファブリック
EVPN-VXLAN によるリーフスパイン型データセンターファブリック:テナントごとの VRF と VNI、EVPN マルチホーミング、BGP unnumbered、ルートターゲットフィルタリング。
概要資料を入手OcNOS-DC データシート
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
OcNOS 800G ロスレス AI Fabric
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
EVPN-VXLAN データセンターファブリック
簡単なフォームです。送信後すぐに PDF が新しいタブで開きます。
✓ PDF を新しいタブで開いています…
開かない場合は、下記のリンクをご利用ください。
OcNOS で AI ファブリック全体を設計
ビジネスケースからポート数の計算まで、構築のどの段階からでも着手できます。
GPU ファブリック向けに DLB をチューニング中ですか。ワークロード固有のレビューをご利用ください
GPU 規模とコレクティブパターンをお知らせいただければ、IP Infusion のエンジニアがフローレットタイマーとパススコアリングを共にチューニングします。あるいは AI Fabric Design Suite で一次案の leaf-spine レイアウトから始めることもできます。